
티스토리 뷰
생성형 AI로 이미지를 만들고 콘텐츠를 기획하다 보면 편리함에 감탄하는 순간이 먼저 옵니다.
그런데 저는 어느 순간부터 문득 불안해지기 시작했습니다.
제가 무심코 입력한 텍스트나 이미지가 어딘가에서 무단으로 학습 데이터로 쓰이고 있지는 않을까,
혹은 제가 만든 콘텐츠가 딥페이크 기술로 악용되는 세상 어딘가에서
누군가의 피해로 이어지고 있지는 않을까 하는 생각 말입니다.
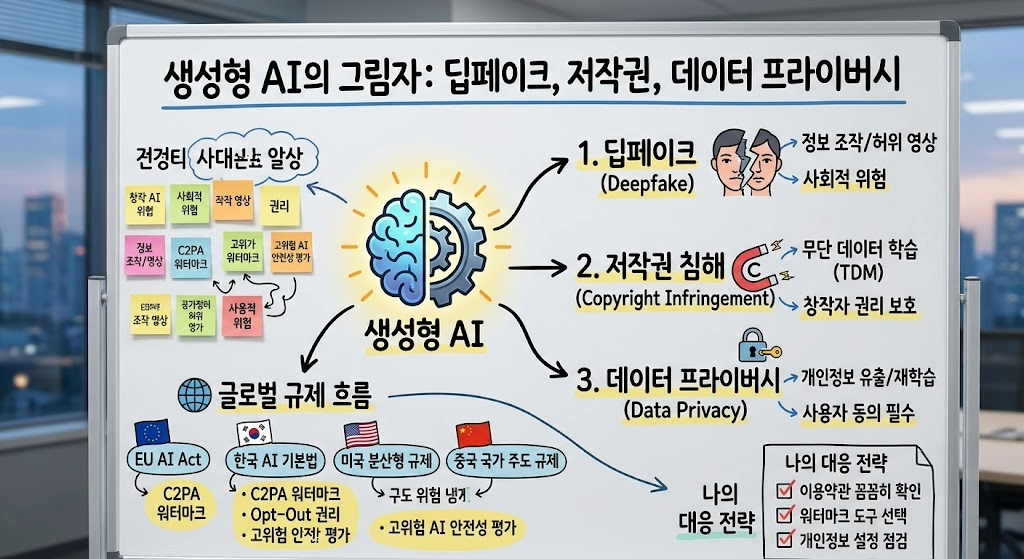
딥페이크, 저작권 침해, 데이터 프라이버시 — 이 세 가지 문제가 결국 같은 뿌리에서 나오고 있다는 걸,
각국의 규제 흐름을 직접 찾아보면서 비로소 정리할 수 있었습니다.
딥페이크·저작권·프라이버시, 왜 지금 문제인가
솔직히 말하면, 저는 AI가 생성한 이미지를 블로그 썸네일로 쓰면서도 저작권 문제를 한 번도 진지하게
따져본 적이 없었습니다.
'내가 프롬프트를 입력했으니 내 것'이라는 막연한 생각이었죠. 그런데 알고 보니 이 문제는 생각보다 훨씬 복잡했습니다.
먼저 딥페이크(Deepfake) 이야기를 해야 합니다.
딥페이크란 딥러닝(Deep Learning) 기술을 활용해 실제처럼 보이는 허위 영상이나 음성을 합성하는 기술을 말합니다.
처음에는 영화 특수효과용으로 주목받았지만, 지금은 성적 허위 영상물 제작이나 정치인 발언 조작,
금융 사기에 이르기까지 범죄 수단으로 광범위하게 악용되고 있습니다.
제가 직접 써봤는데, 몇 줄의 프롬프트만으로 특정인의 얼굴을 합성하는 수준이
이미 일반인이 구별하기 어려울 만큼 정교해졌다는 사실이 솔직히 섬뜩했습니다.
저작권 문제도 마찬가지입니다.
AI 모델을 학습시키는 과정에서 TDM(Text and Data Mining),
즉 텍스트·이미지·음악 등 방대한 저작물을 자동으로 수집·분석하는 기술이 사용됩니다.
여기서 TDM이란 대량의 데이터를 기계가 자동으로 읽고 패턴을 추출하는 기법으로,
AI의 학습 능력을 높이는 핵심 방식입니다.
문제는 이 과정에서 원 저작권자의 동의를 구하지 않는 경우가 대부분이라는 점입니다.
제 경험상 이 부분이 가장 '회색지대'처럼 느껴졌고, 현행법의 공백이 가장 크게 드러나는 지점이기도 했습니다.
데이터 프라이버시(Data Privacy) 리스크도 빼놓을 수 없습니다.
사용자가 AI 서비스에 입력한 개인정보나 대화 내용이 사전 동의 없이 모델 재학습에 활용될 수 있다는 우려는,
저 역시 특정 생성형 AI 서비스를 쓰다가 이용약관을 꼼꼼히 읽고 나서야 처음으로 실감했습니다.
"이 데이터가 학습에 쓰일 수 있다"는 문장이 약관 깊숙한 곳에 묻혀 있었거든요.
요약: 딥페이크·TDM 기반 저작권 침해·데이터 프라이버시 유출은 기술 발전의 속도가 법과 제도를 앞질러 생기는
구조적 공백에서 비롯됩니다.
EU·한국·미국·중국, 각국 저작권·규제 대응 비교
이 문제를 어떻게 풀 것인지에 대해 각국이 내놓은 해법은 꽤나 다릅니다.
제가 직접 각국 법안을 찾아 비교해 봤는데, 방향성이 같아 보여도 접근 방식은 상당히 달랐습니다.
가장 앞선 규제로 평가받는 것은 EU의 'EU AI Act'입니다.
2024년 공식 발효된 이 법은 위험 기반(Risk-Based) 규제 방식을 채택했습니다.
위험 기반 규제란 AI 시스템의 위험도를 4단계로 분류하고, 단계별로 다른 의무를 부과하는 방식입니다.
특히 AI가 생성한 콘텐츠에 C2PA 워터마크(기계 판독이 가능한 메타데이터 형태의 출처 표시)를 의무적으로
삽입하도록 규정했습니다.
위반 시 글로벌 매출액의 최대 7%에 달하는 과징금을 부과합니다
(출처: EU Official Journal, Regulation (EU) 2024/1689).
한국도 세계에서 두 번째로 포괄적 AI 규제법으로 꼽히는 'AI 기본법'을 시행하고 있습니다.
이 법은 '고영향 AI', 즉 금융·채용·의료·공공 등 사람의 생명이나 권리에 직접 영향을 미치는
AI에 대해 사전 영향평가와 인간 감독(Human-in-the-Loop) 체계를 의무화했습니다.
생성형 AI 결과물의 워터마크 표시 의무도 명시되어 있어, EU AI Act의 방향과 상당 부분 일치합니다
(출처: 한국저작권위원회).
반면 미국은 연방 차원의 단일 규제법보다는 주(州) 단위 접근을 선택했습니다.
캘리포니아나 뉴욕 등 주요 주에서 딥페이크 금지법과 데이터 보호 규제를 별도로 운영하는 분산형 구조입니다.
중국은 정반대로, 생성형 AI 서비스를 출시하기 전 정부 등록과 보안 평가를 반드시 거쳐야 하는
국가 주도 직접 규제 방식을 택했습니다.
핵심 규제 장치 3가지 비교
제가 각국 법안을 정리하면서 공통적으로 등장하는 핵심 장치는 세 가지였습니다.
- 워터마킹(Watermarking) 의무화: EU AI Act와 한국 AI 기본법 모두 AI 생성물에 사람 또는 기계가 식별할 수 있는
출처 표시를 부착하도록 했습니다.
C2PA 워터마크는 이미지나 영상 파일 안에 메타데이터로 삽입되어 딥페이크 여부를 기계적으로 판별하는 방식입니다. - TDM 학습 거부권(Opt-Out): 저작권자나 데이터 주체가 자신의 저작물 및 개인정보를
AI 학습 데이터로 활용하지 못하도록 법적으로 거부 의사를 표명할 수 있는 권리입니다.
EU에서는 이미 법적 근거가 마련됐고, 국내도 논의가 진행 중입니다. - 고위험 AI 안전성 평가: 금융, 채용, 의료처럼 개인의 권리에 실질적인 영향을 주는 AI는
출시 전 영향평가를 반드시 수행하고, 자동화된 결정 과정에 반드시 인간 감독자가 개입하도록 하는
Human-in-the-Loop 체계를 갖춰야 합니다.
요약: EU는 위험 기반 분류와 C2PA 워터마크 의무화로 가장 촘촘한 그물을 쳤고,
한국은 이를 상당 부분 따라가는 구조입니다. 미국과 중국은 방향이 정반대로 나뉩니다.
데이터 프라이버시 시대, 실전에서 어떻게 대응할까
규제 흐름을 파악하고 나서 제가 가장 먼저 바꾼 것은 AI 도구를 사용할 때의 태도였습니다.
이전에는 "결과물이 좋으면 됐지"라는 식이었다면, 지금은 쓰기 전에 반드시 그 서비스의 데이터 프라이버시 정책과
저작권 약관을 확인하는 습관을 들이고 있습니다. 번거롭지만, 이게 사실 가장 현실적인 방어선입니다.
글로벌 시장에 서비스를 출시하는 기업이라면 이야기가 더 복잡해집니다.
EU AI Act처럼 가장 높은 기준을 요구하는 규제에 맞춰 AI 거버넌스를 설계하는 것이 결국 가장 안전한 전략입니다.
제 경우에도 콘텐츠를 해외에 배포할 때는 C2PA 워터마크가 자동 적용되는 도구를 우선적으로 선택하게 되었습니다.
이건 규제 때문이기도 하지만, 제가 만든 콘텐츠의 신뢰도를 높이는 데도 실제로 도움이 됐습니다.
그렇다고 현재의 규제 방향이 완전히 이상적이라고 보기는 어렵습니다.
저는 개인적으로 과도한 규제가 스타트업과 중소 개발사에게 치명적인 진입장벽이 될 수 있다는 점이 우려됩니다.
고위험 AI 영향평가 절차와 법적·기술적 대응 비용을 감당할 여력이 있는 쪽은 결국 대형 빅테크뿐입니다.
잘못된 방향으로 설계된 규제는 오히려 AI 시장의 독점화를 심화시킬 수도 있습니다.
국가 간 규제 불균형도 문제입니다.
한 나라가 아무리 정교한 워터마크 부과와 데이터 보호법을 만들어도, 규제가 느슨한 다른 나라의 플랫폼이나
오픈소스 모델로 만들어진 딥페이크 영상은 국경을 넘어 순식간에 퍼집니다.
제 생각에는 실효성 있는 규제가 되려면 글로벌 공통 가이드라인 수립과 기술적 탐지 도구 개발 지원이
동시에 이루어져야 합니다.
요약: 규제를 이해하고 가장 높은 기준(EU AI Act)에 맞춰 도구와 절차를 선택하는 것이 개인과 기업 모두에게
가장 현실적인 대응 전략입니다.
자주 묻는 질문
Q. AI로 만든 이미지는 저작권이 누구한테 있나요?
A. 현재 국내외 법률에서 AI 생성물의 저작권 귀속은 여전히 명확히 정리되지 않은 영역입니다.
미국 저작권청은 순수하게 AI가 생성한 결과물에 대해서는 저작권을 인정하지 않는다는 입장을 여러 차례 밝혔습니다.
한국도 아직 판례가 쌓이는 단계이므로, 중요한 용도로 사용할 경우에는 반드시 해당 플랫폼의 이용약관을 먼저
확인하시는 것이 안전합니다.
Q. C2PA 워터마크가 뭔지 좀 더 쉽게 설명해주실 수 있나요?
A. C2PA(Coalition for Content Provenance and Authenticity) 워터마크는 이미지나 영상 파일 안에 '이 콘텐츠가 언제,
어떤 도구로 만들어졌는지'를 기록하는 디지털 서명 방식입니다.
눈에 보이지 않지만 기계는 읽을 수 있어서, 딥페이크 여부를 자동으로 판별하는 데 쓰입니다.
EU AI Act에서는 AI 생성 콘텐츠에 이 방식의 출처 표시를 의무화하고 있습니다.
Q. 한국 AI 기본법은 일반 사용자한테도 직접 영향을 미치나요?
A. 직접적인 의무는 주로 AI 서비스를 개발·제공하는 사업자에게 부과됩니다.
다만 생성형 AI 결과물에 워터마크 표시가 의무화되면, 일반 사용자 입장에서는 내가 보는 콘텐츠가
AI가 만든 것인지 아닌지를 더 쉽게 확인할 수 있게 됩니다.
콘텐츠의 신뢰도를 판단하는 기준이 생기는 셈이라, 소비자 보호 측면에서도 의미 있는 변화입니다.
Q. 내 개인정보가 AI 학습에 쓰이는 걸 막을 수 있나요?
A. EU의 GDPR(일반 개인정보보호법)을 기반으로 한 '학습 거부권(Opt-Out)'이 법적으로 강화되고 있습니다.
즉, 데이터 주체가 자신의 정보를 AI 학습에 쓰지 말도록 요청할 수 있는 권리입니다. 현
실적으로는 사용 중인 서비스의 설정 메뉴에서 '데이터 학습 사용 여부'를 직접 확인하고
비활성화하는 것이 가장 빠른 방법입니다.
결론
규제가 혁신을 막는다는 시각도 있지만, 제가 이 문제를 직접 들여다보고 내린 결론은 조금 다릅니다.
딥페이크·저작권·데이터 프라이버시 이 세 가지 문제는 기술이 성숙할수록 저절로 해결되는 성질의 것이 아닙니다.
오히려 기술이 정교해질수록 피해의 규모와 속도도 함께 커집니다.
EU AI Act나 한국 AI 기본법처럼 워터마킹을 의무화하고 고위험 AI에 안전성 평가를 요구하는 흐름은,
창작과 혁신을 막는 장애물이 아니라 기술을 지속 가능하게 쓰기 위한 최소한의 안전벨트라고 생각합니다.
저 역시 앞으로 AI 도구를 쓸 때 단순한 편리함만 좇기보다, 저작권 출처를 확인하고
데이터 프라이버시 설정을 직접 점검하는 습관을 계속 이어가려 합니다.
글로벌 규제 기준이 어떻게 정비되든, 개인 차원에서 가장 높은 기준에 스스로를 맞추는 것이
결국 가장 현명한 선택이라는 생각입니다.
참고: EU Official Journal — Regulation (EU) 2024/1689 (EU AI Act), Article 50 Transparency obligations /
한국저작권위원회 — EU 인공지능법 투명성 의무 실천 강령 이슈리포트 /
법률신문·크로노젠(Cronozen): AI 기본법 시행령과 EU AI Act 비교 분석 /
National Law Review·Kiteworks: 2026 AI Regulation & Deepfake Legislation Compliance Guide
- Total
- Today
- Yesterday
- 초개인화쇼핑
- 보이스피싱
- 네팔재해
- 딥페이크사기
- 기후변화재난
- 2030러닝
- 달리기트렌드
- ETF투자
- 초고독사회
- 스트리밍중계권
- 아이방 가전
- 돌발홍수
- 네팔홍수
- 검진휴가
- 2026민생정책
- aHBM
- 빙하호붕괴
- 제로클릭커머스
- 지방세제개편
- ZHBM
- 봄가을스타일링
- 지방주거복지세
- 초등 학습 환경
- 매너런
- 3040자산관리
- GLOF
- N잡파이프라인
- Claude활용법
- 디지털 역설
- 비대면금융범죄
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |